实战案例:
1 需求与总体架构
需求:课题组每周精读多篇教育数据挖掘/知识追踪方向论文,需要"批量抓取 arXiv/期刊论文 PDF → 解析为结构化文本/TeX → 生成中英对照版"的自动化管线,人力只做选题与审校。
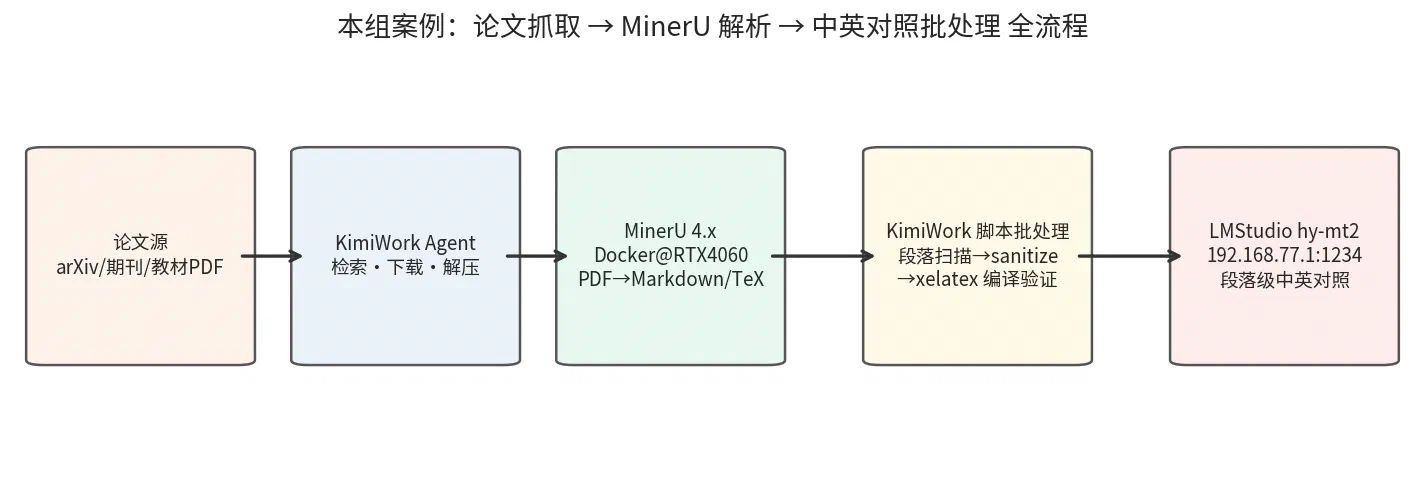
架构选择:KimiWork Agent 负责任务编排与脚本开发;MinerU 4.x 以 Docker 部署在本机 RTX 4060(8GB),提供 Gradio WebUI(localhost:7860)与 HTTP API;LMStudio 加载 hy-mt2-1.8b 翻译模型,以 OpenAI 兼容 API 暴露在局域网(192.168.77.1:1234);产物经 xelatex 编译验证后 git 版本化。
2 论文抓取:脚本实现过程
流程:arXiv 检索(关键词+年份过滤)→ 元数据(标题/作者/摘要/版本号)→ PDF 与 TeX 源码包下载 → 解压归档到 paper/tex/<key>/ → 写工作日志。
关键技术点:
- arXiv API 批量查询 + 反爬策略(限速、重试、UA 轮换);期刊源用浏览器自动化兜底;
- 幂等设计:以
<作者><年份><关键词>为目录键,重复抓取自动跳过; - 57 篇论文一次性归档成功,2 篇无 TeX 源码的只留 PDF 占位。
参考来源:本组工作日志 log/2026-09-15-work-log.md ~ log/2026-09-20-work-log.md;context/2026-09-22-session-context.md(管线存档)
3 MinerU 解析集成
为什么选 MinerU:OpenDataLab(上海 AI 实验室)开源的一站式文档解析工具,PDF→Markdown/JSON,公式转 LaTeX、表格转 HTML、84+ 种语言 OCR,源于"书生·浦语"大模型预训练的数据清洗需求 [19]。
部署(Docker 路线) [19][20]:
docker pull opendatalab/mineru:latest
# GPU 版需 --gpus all;compose.yaml 提供 api / gradio / vllm-server 三种 profile
docker compose -f compose.yaml --profile gradio up -d   # → localhost:7860
4.x 版本要点(2026-09 发布通道)[19][21]:
- 四档解析质量:
flash(纯文本层,无推理)/basic(小模型 OCR,CPU 可跑)/standard(小模型+VLM,默认)/advanced(高难度文档加码推理); - 模型栈:PP-DocLayoutV2 版面检测 + PP-OCRv6 检测/识别 + PP-FormulaNet 公式 + 表格模型 + VLM(llama.cpp Vulkan / vLLM / LMDeploy 三引擎可独立配置);
- V1 HTTP API(
/v1/uploads、/v1/parse/jobs)与 Gradio WebUI 共享同一结构化结果; - 面向 Agent 的官方 Skill 已发布(mineru.net/news,2026-03),一条
mineru parse document.pdf --json即可让智能体读 PDF。
本机实测(RTX 4060 Laptop 8GB,截图见下):19.2MB、38 页中文教材(含扫描页,强制 OCR),advanced 档 157.9 秒完成,GPU 显存峰值约 6.8/8.0 GB、温度 73°C;英文论文 advanced 档约 60–90 秒/篇。
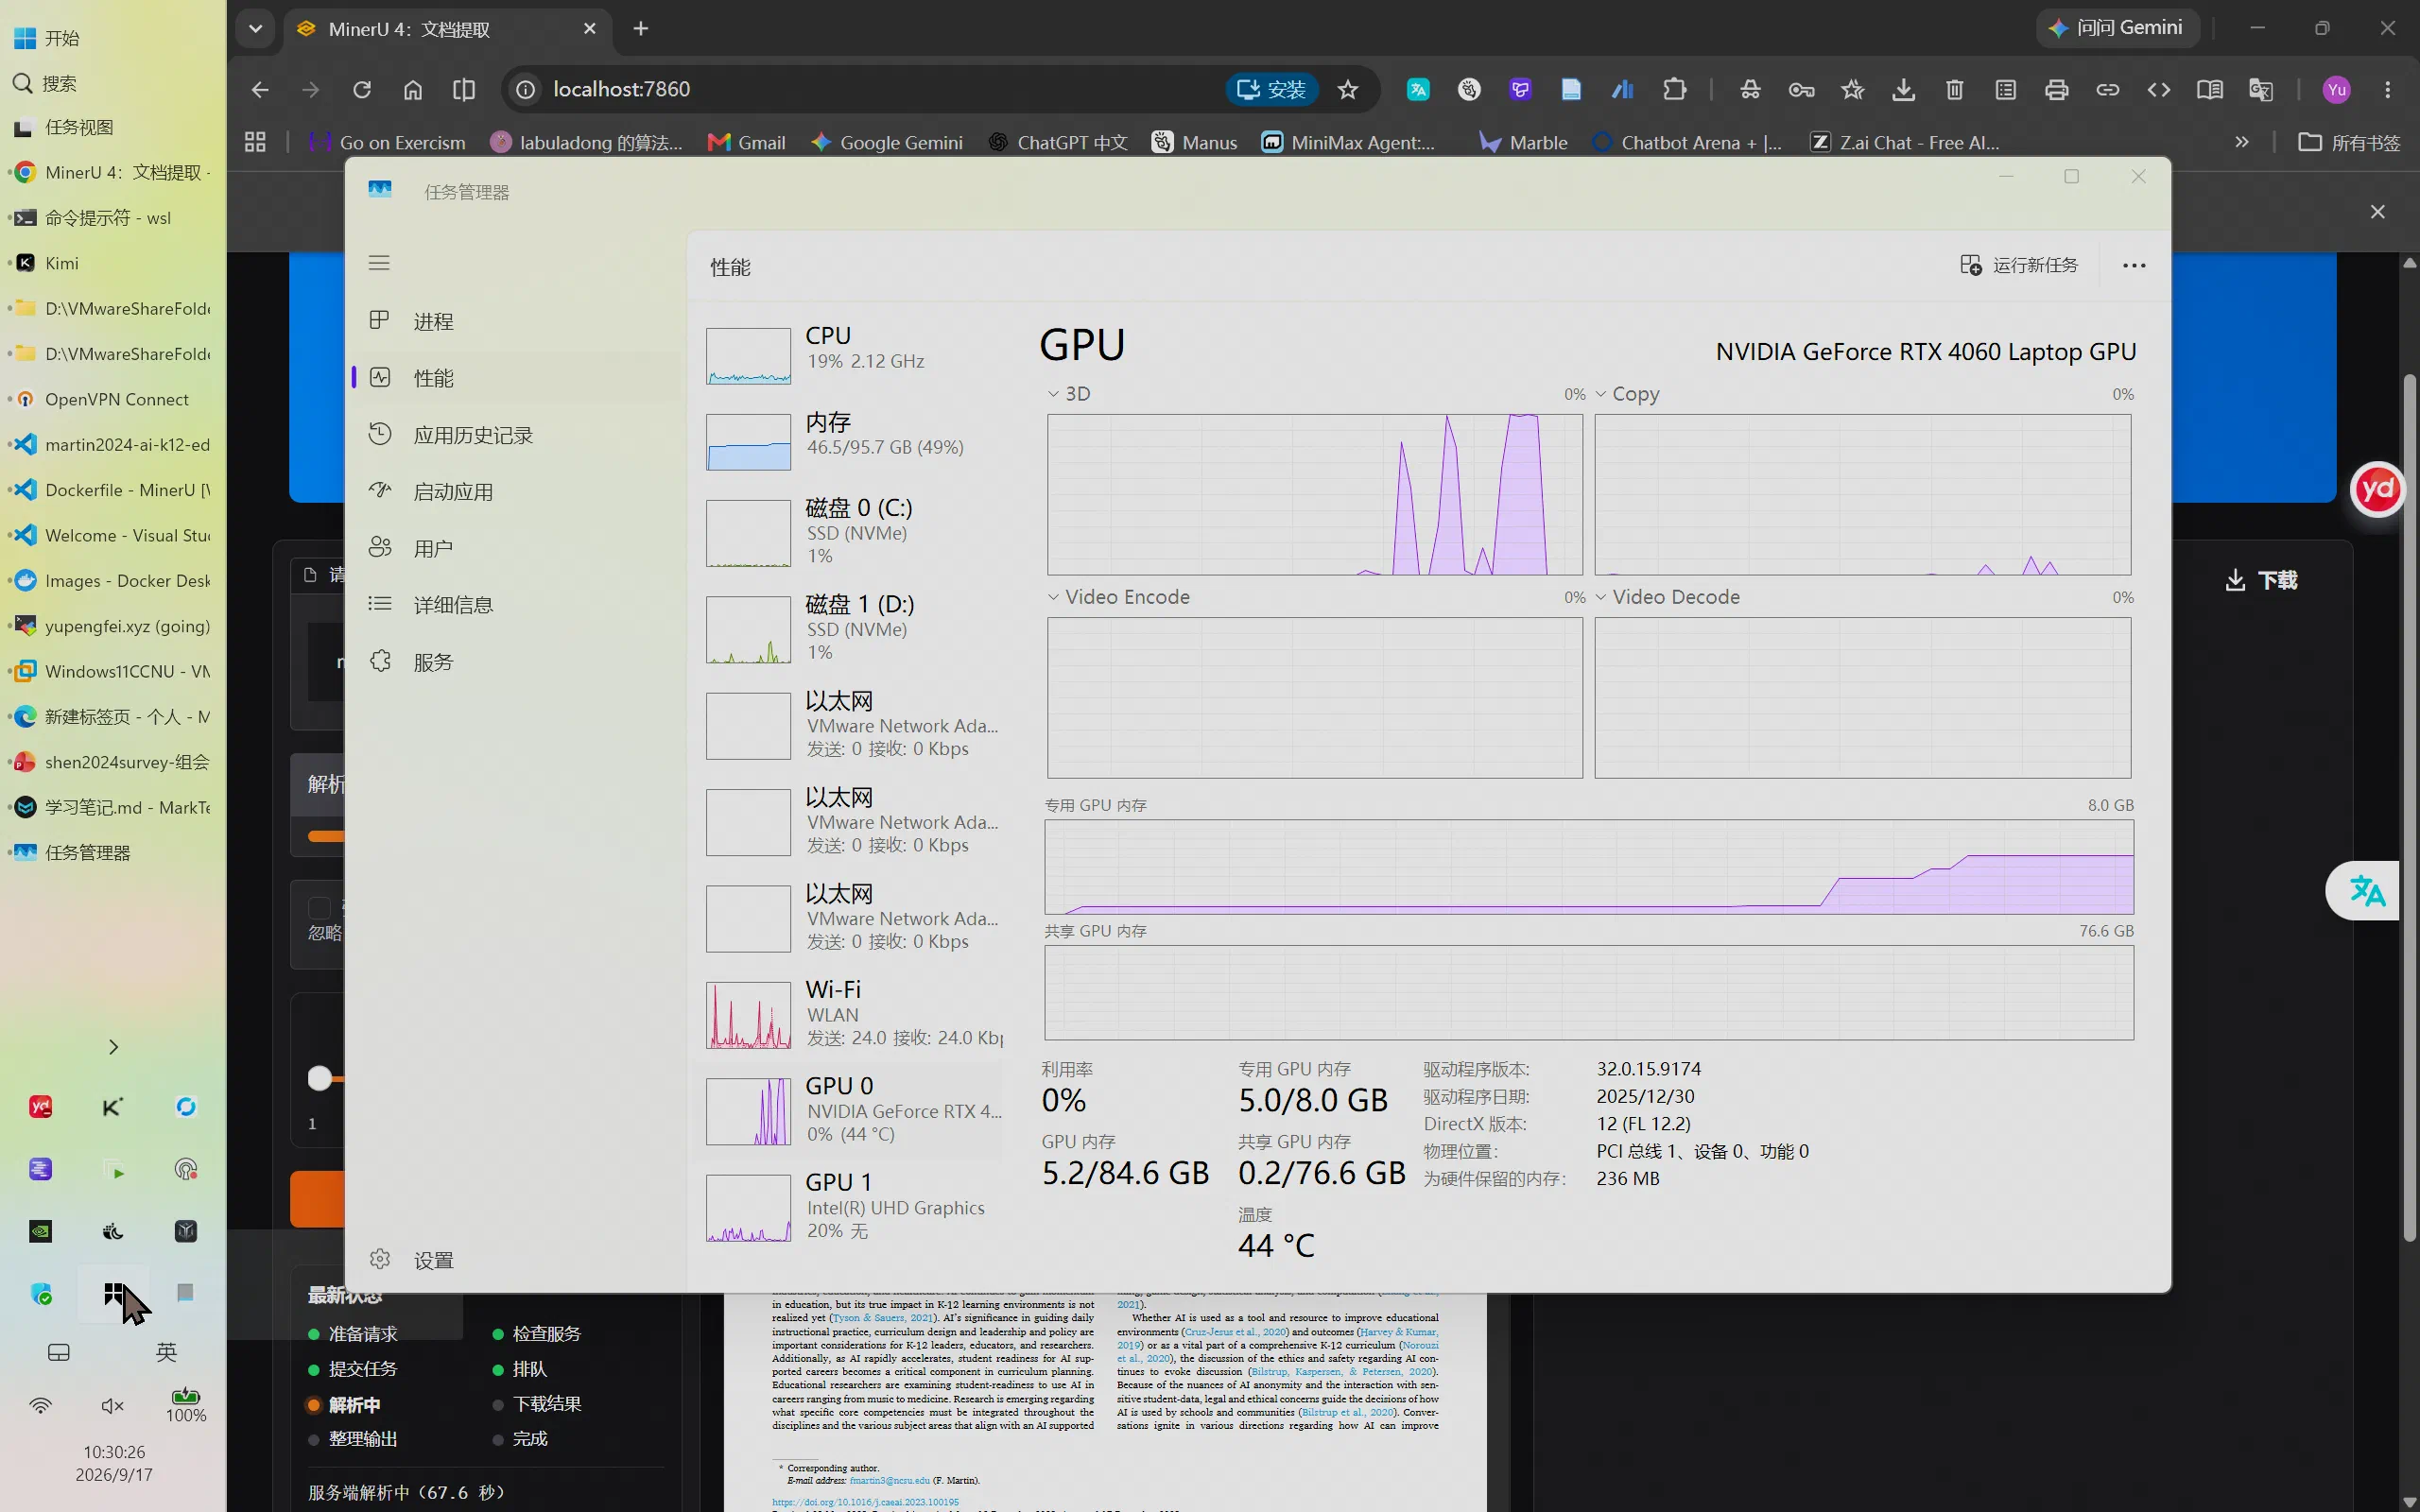
图:MinerU WebUI 解析论文 + 任务管理器观察 GPU 占用(2026-09-17)
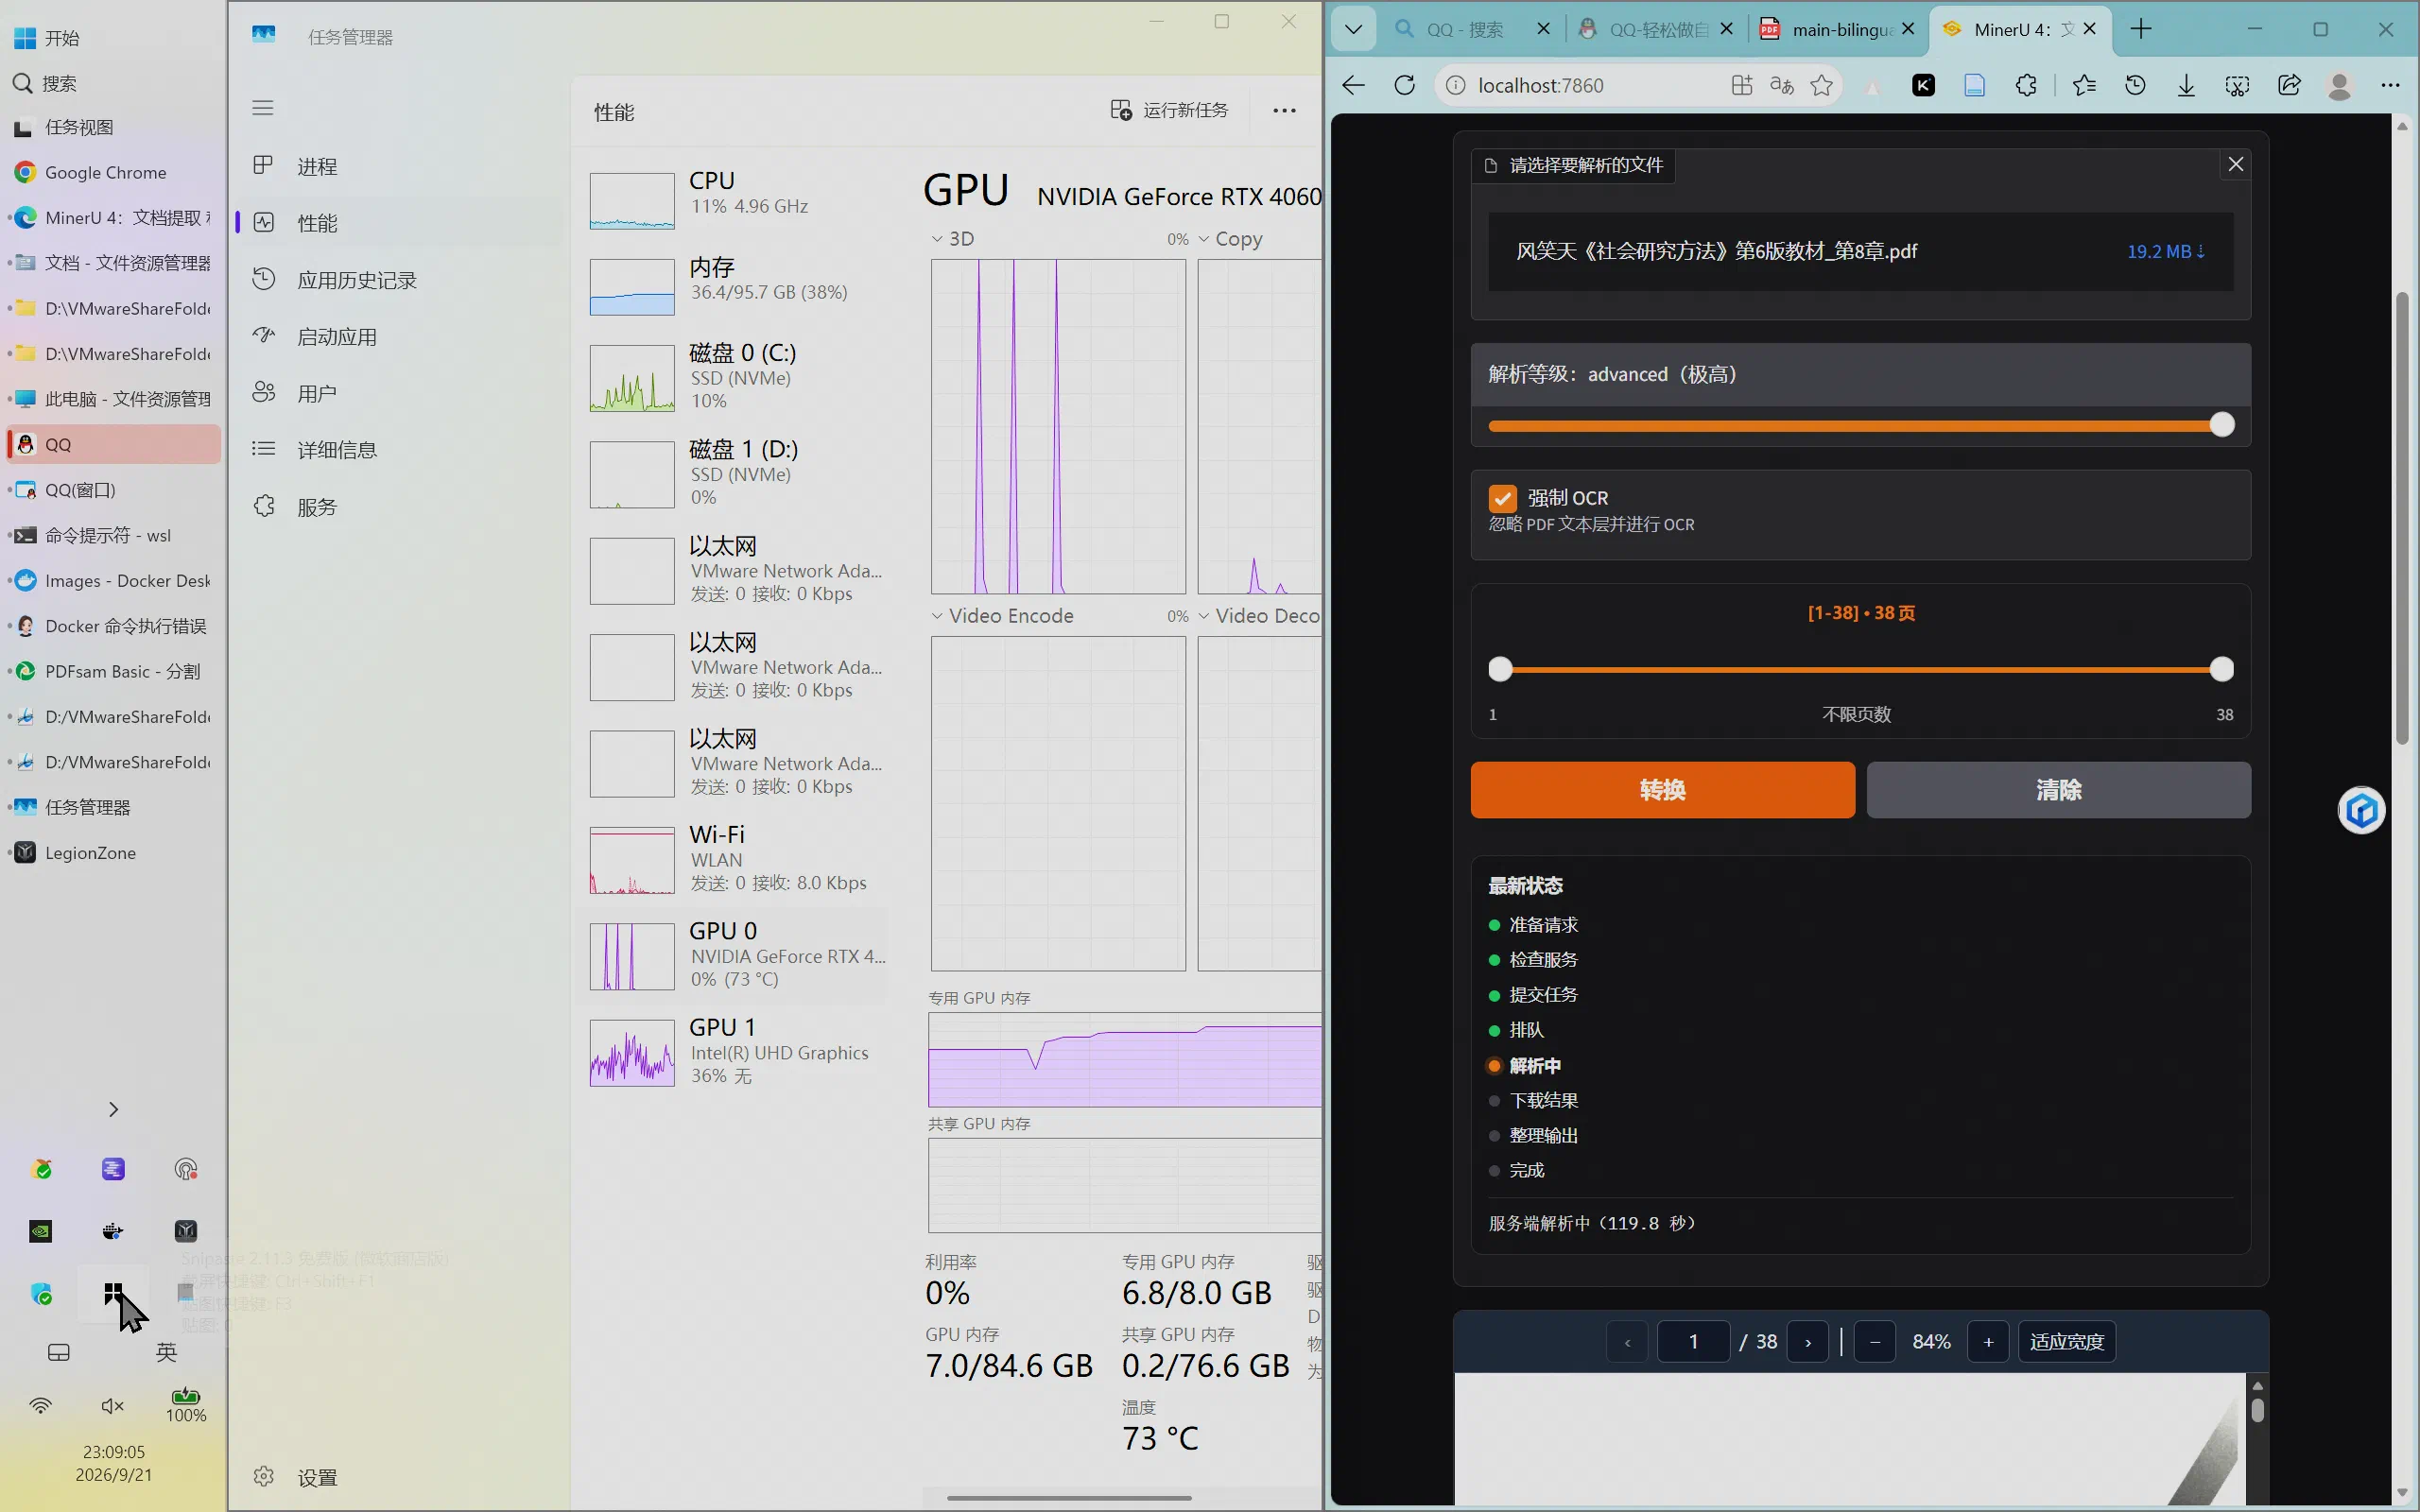
图:19.2MB/38 页中文教材强制 OCR 解析中,GPU 6.8/8.0GB(2026-09-21)
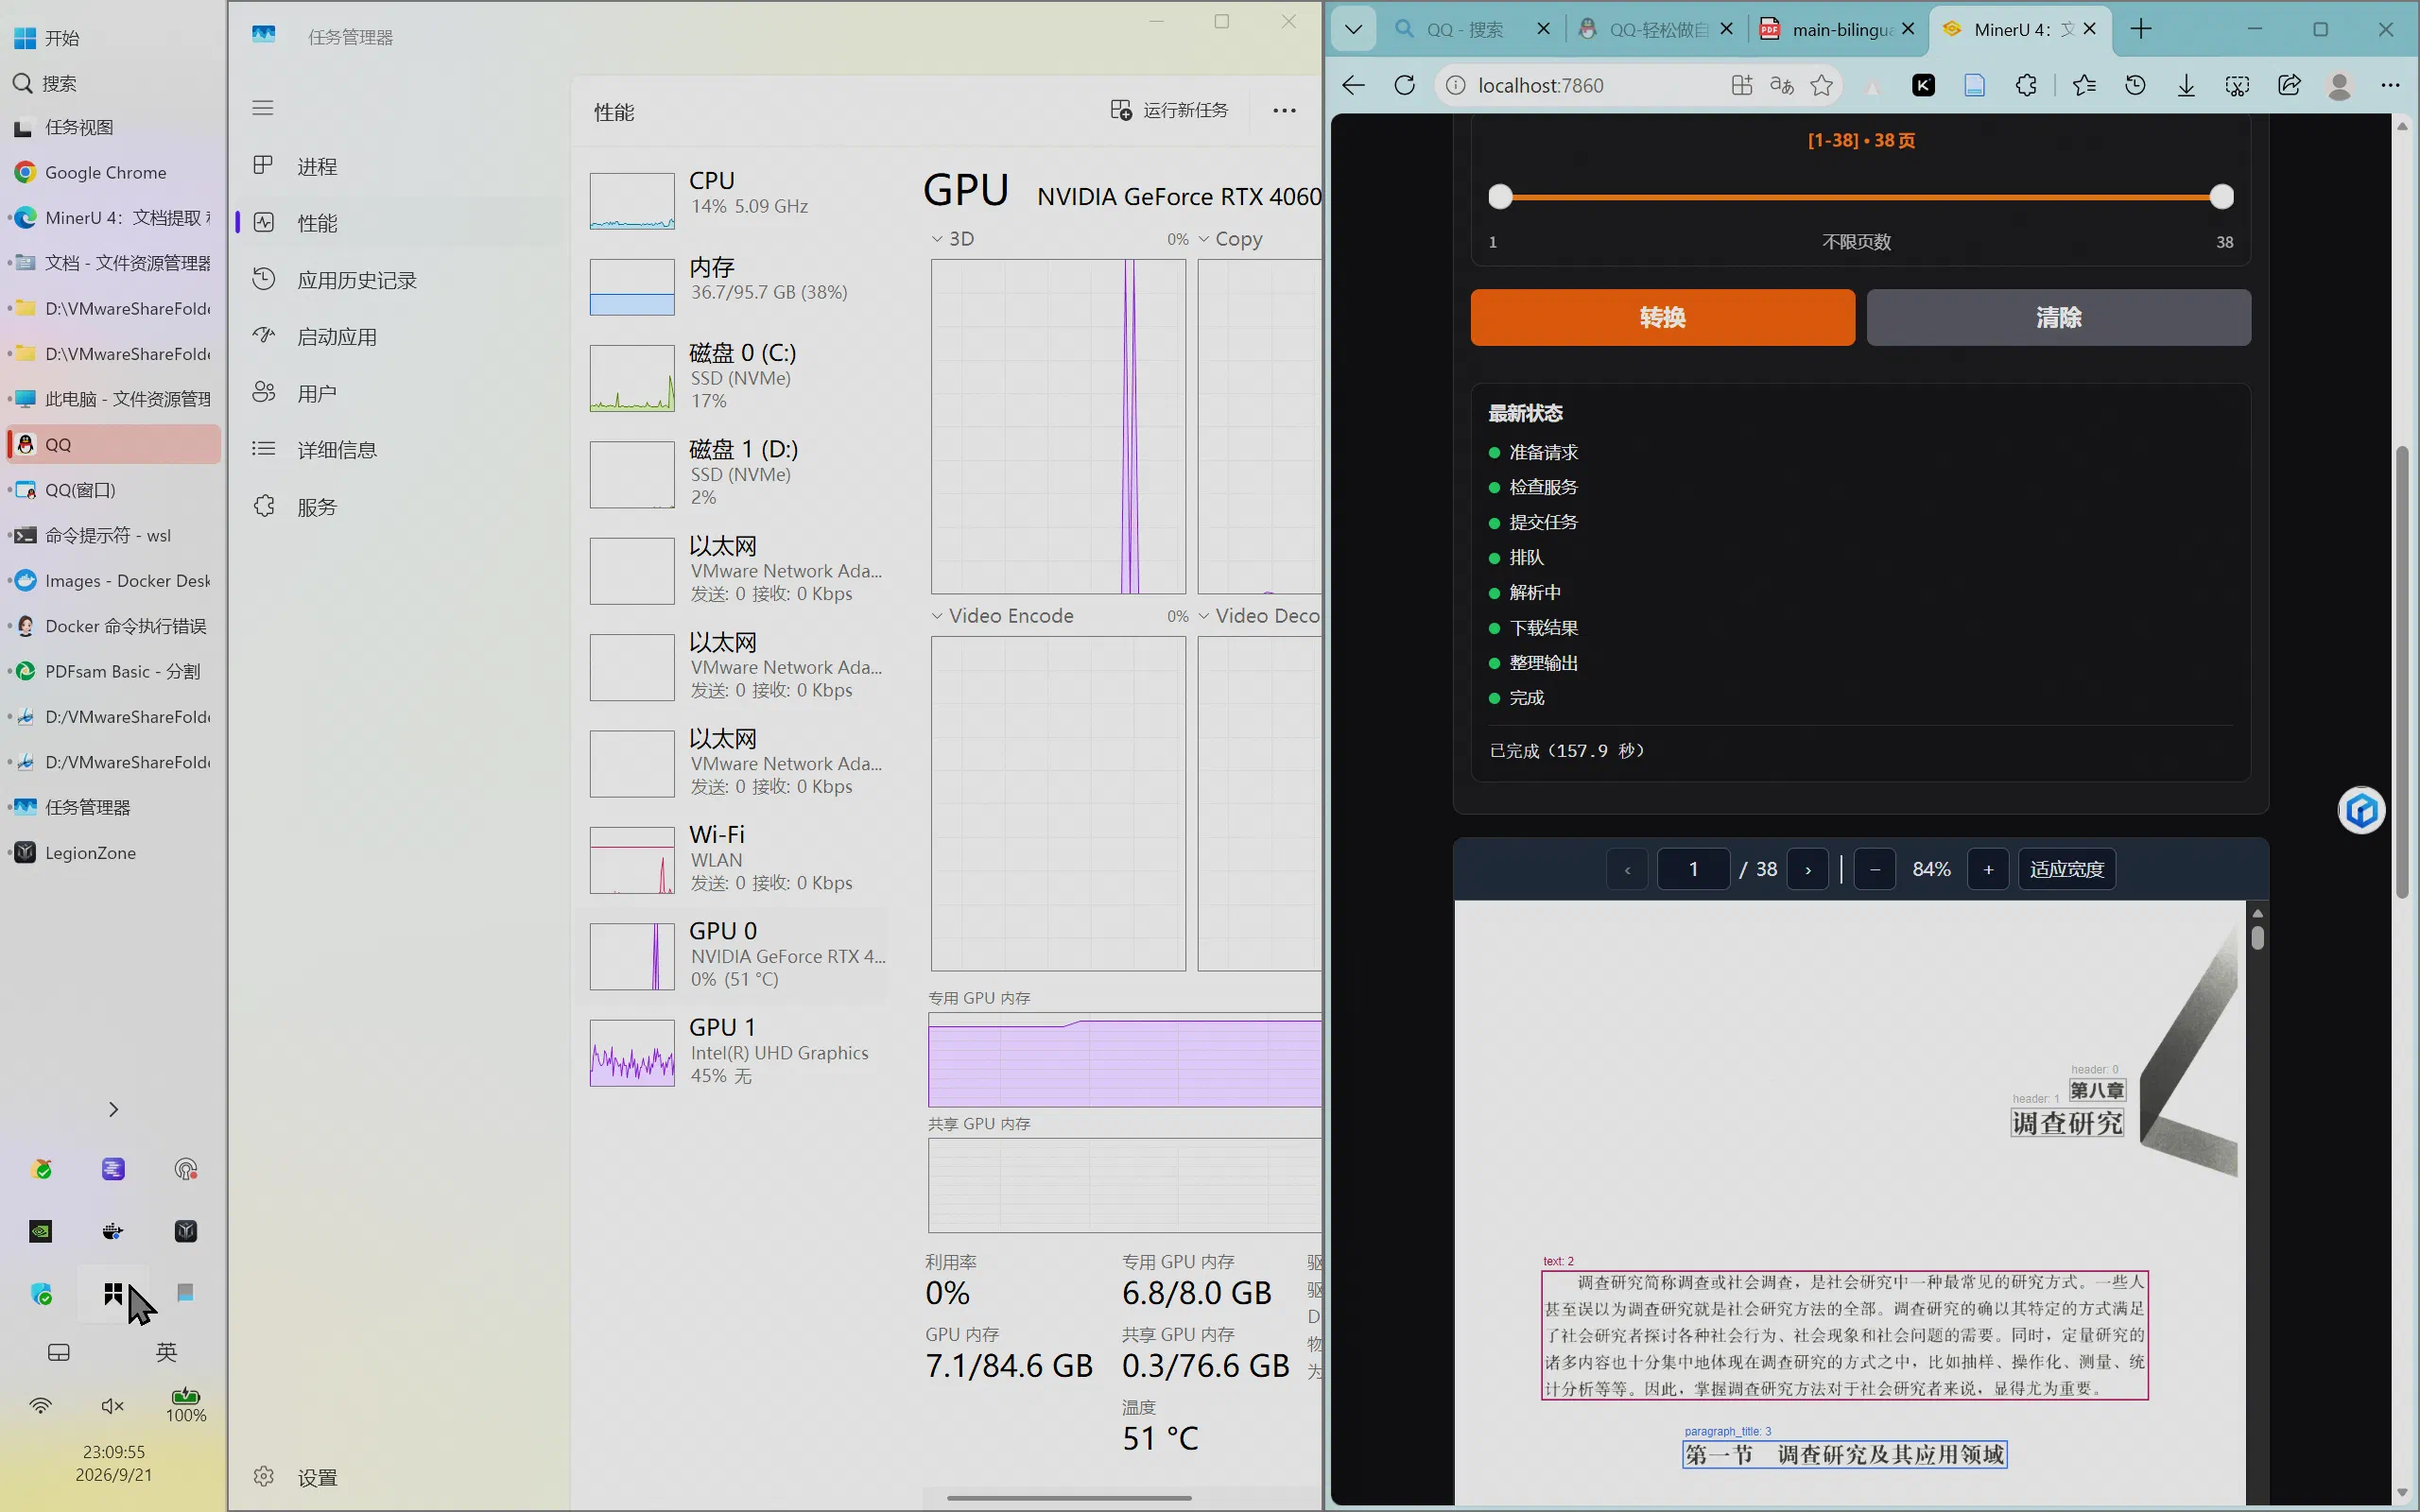
图:解析完成(157.9s),版面分析结果渲染预览(2026-09-21)
参考来源:[19] MinerU GitHub README(https://github.com/opendatalab/MinerU);[20] 阿里云开发者社区《MinerU Docker 部署指南》;[21] MinerU Releases 4.0.x 更新日志(https://github.com/opendatalab/MinerU/releases);mineru.net/news 官方 Skill 公告(2026-03-20)
4 中英对照批处理(LMStudio hy-mt2)
管线(tmp/batch_bilingual.py):扫描 TeX 正文段落 → 切块 → 调 LMStudio hy-mt2-1.8b 逐段翻译(temperature 0,md5 缓存 4325 条)→ sanitize 后插入蓝色 \zh{} 译文 → 标题加中文副题 → xelatex 编译验证。
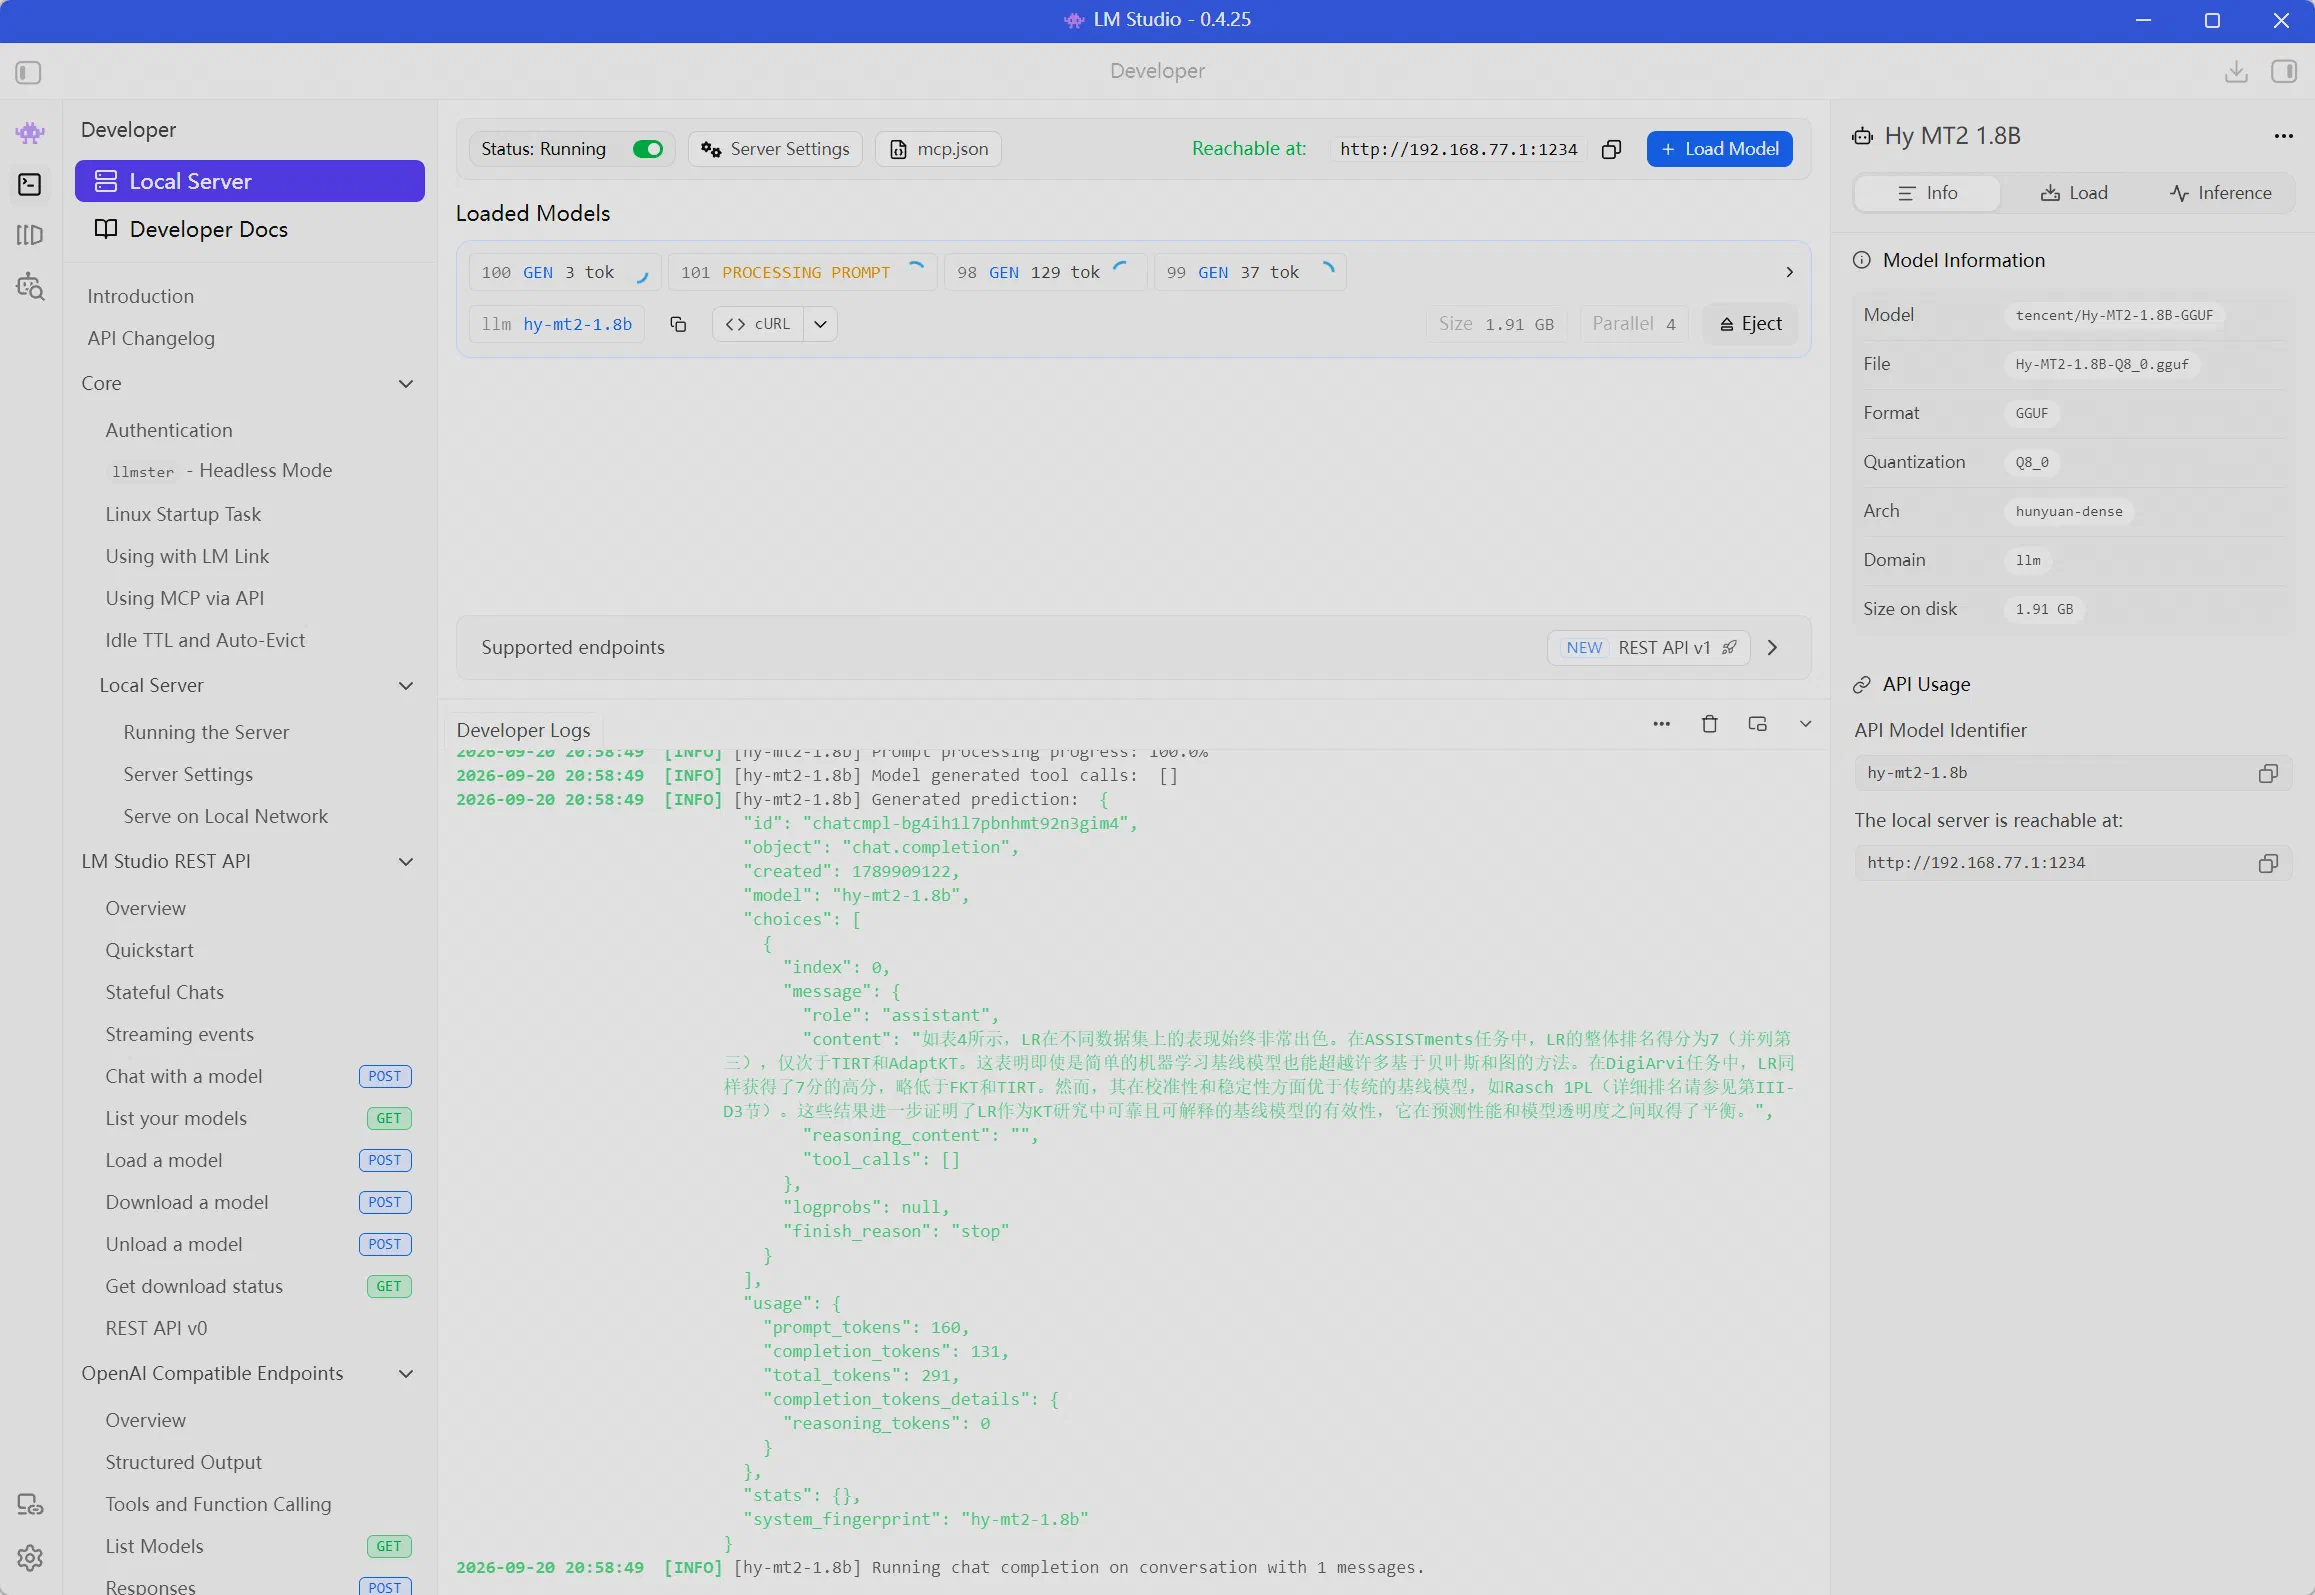
图:LMStudio 0.4.25 加载 hy-mt2-1.8b(1.91GB,Q8_0),OpenAI 兼容端点 http://192.168.77.1:1234,开发者日志可见 chat completion JSON(2026-09-20)
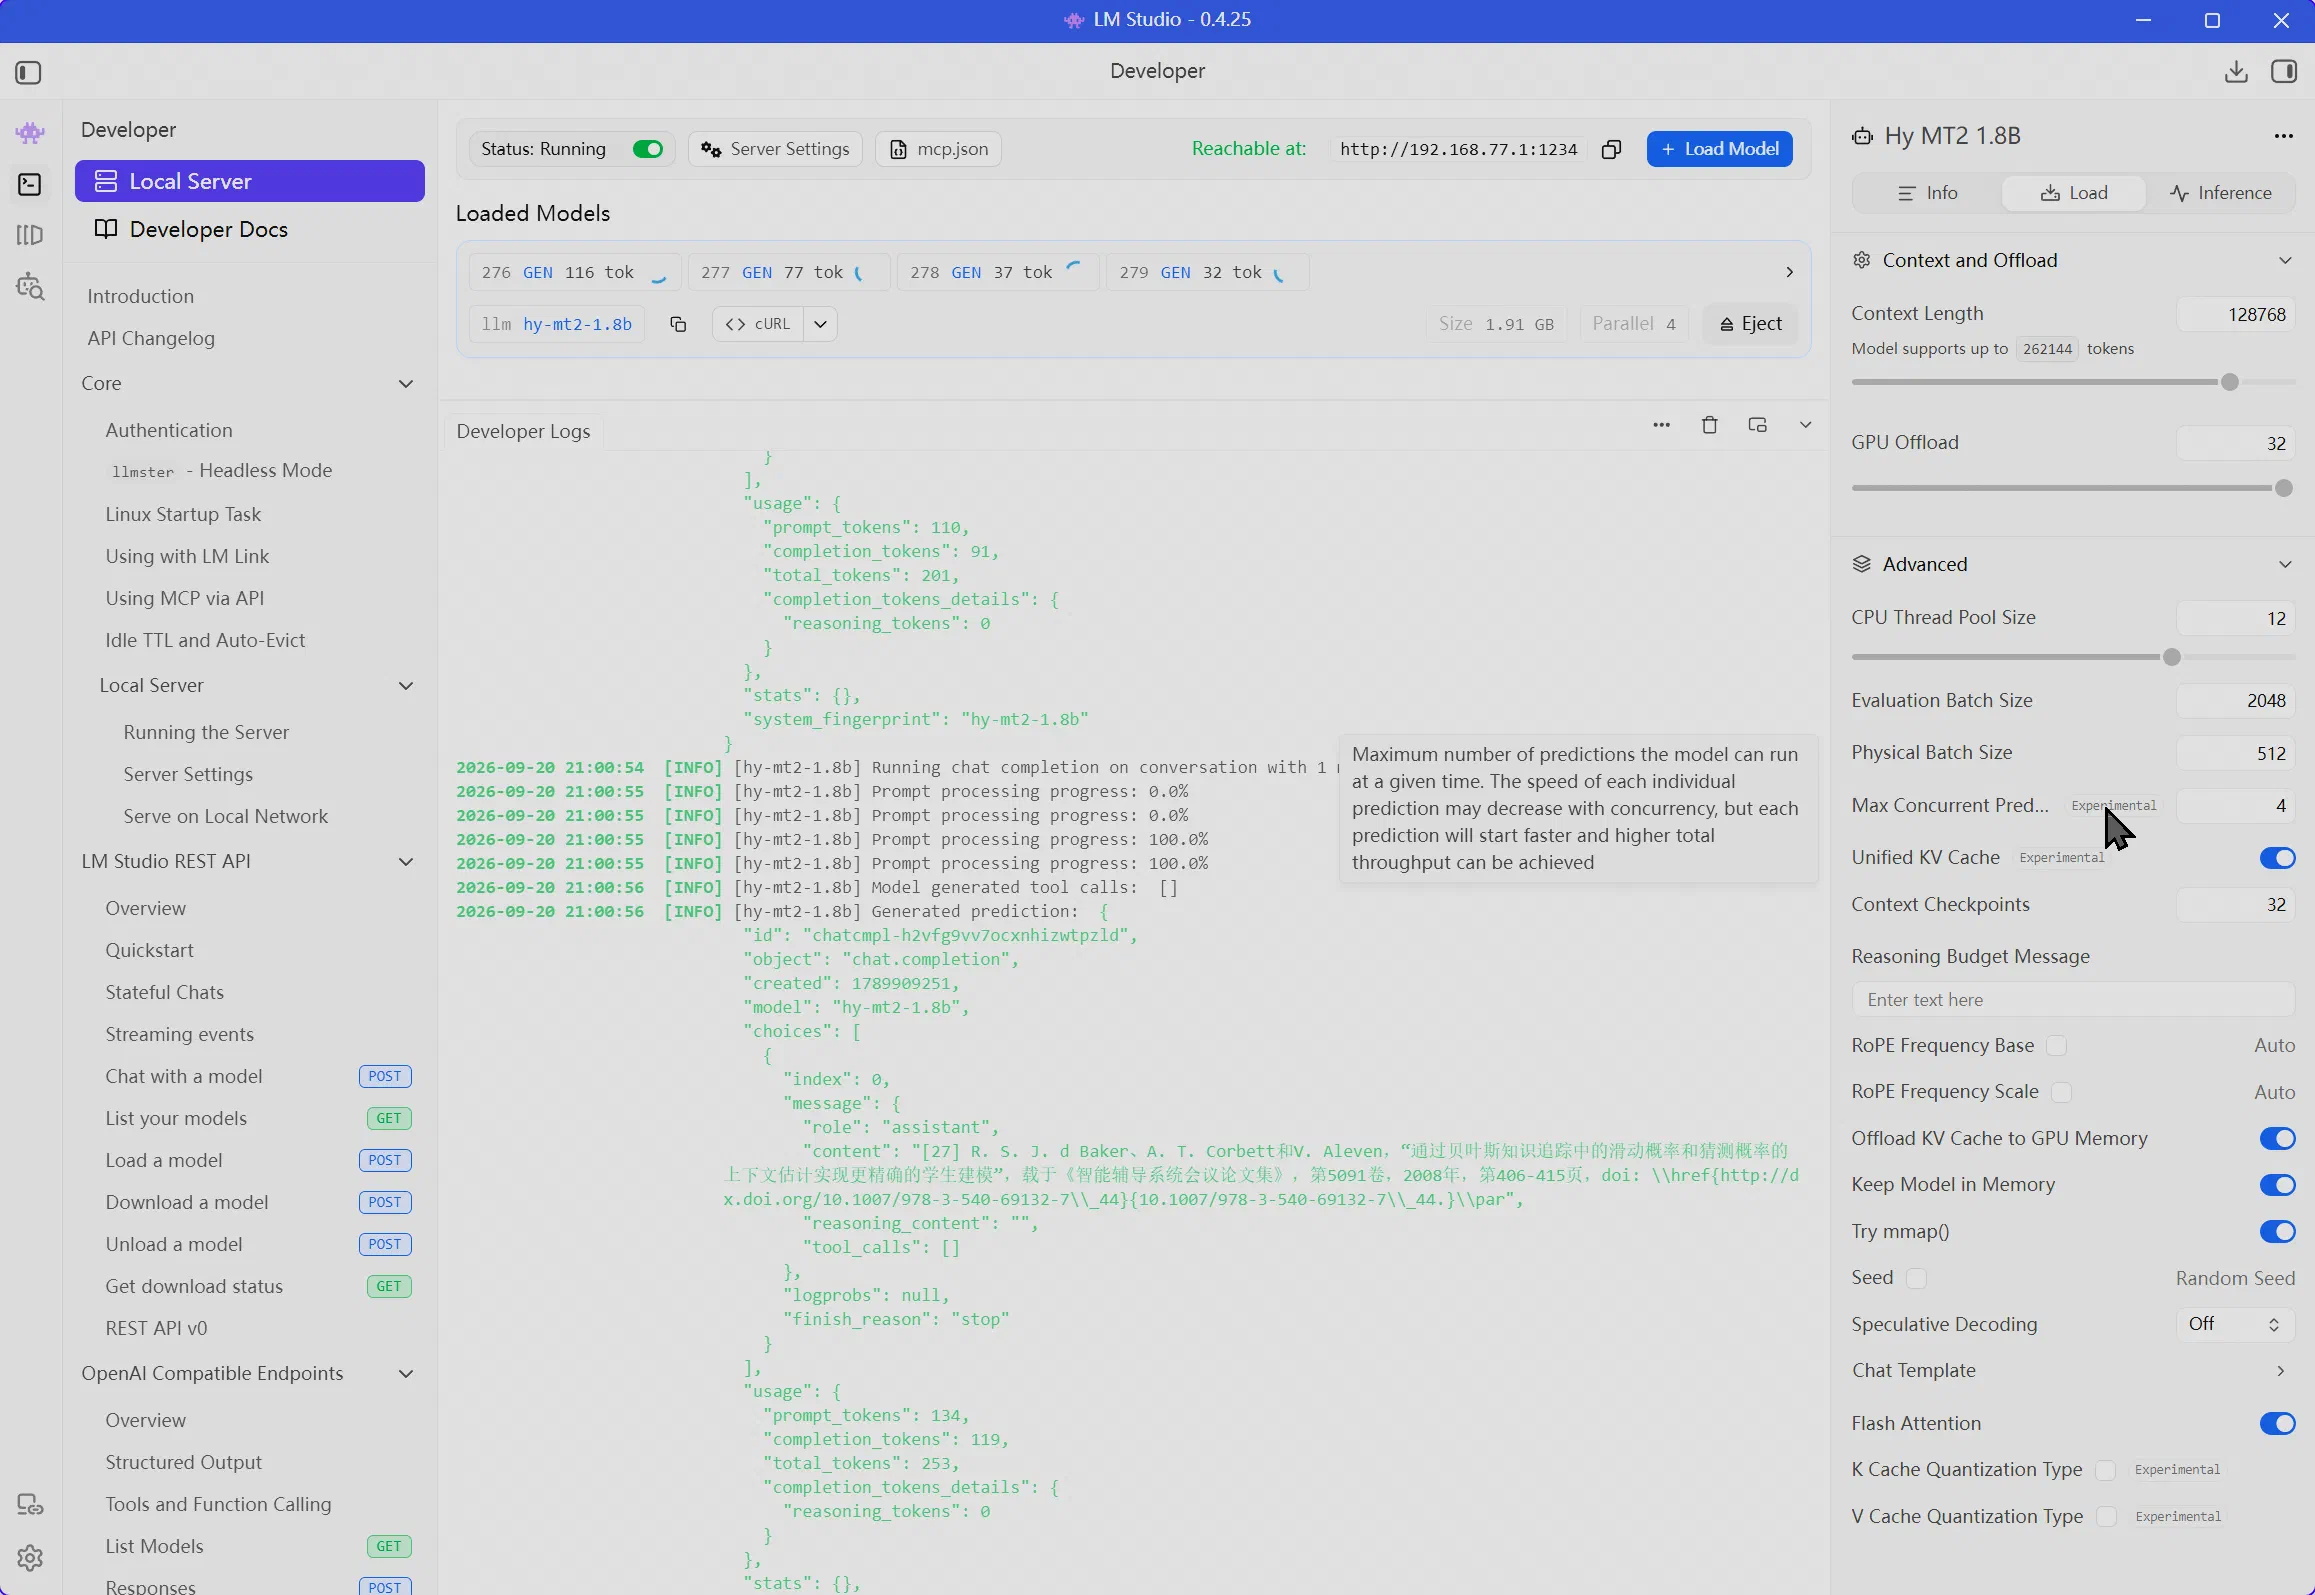
图:hy-mt2 上下文 262144、GPU Offload 32 层、Max Concurrent 4——正是"并发长请求占满 KV cache 挂死"问题的配置现场(2026-09-20)
踩坑实录(已沉淀为 skill,此处择要):
- 缓存锁死锁:持非重入锁调 save,第 20 条译文时全部线程冻结——锁内只置标志、锁外落盘;
- 服务端 KV 挂死:并发"长 prompt + max_tokens 2048"占满 LMStudio KV cache,请求永不返回——max_tokens 限 1024 降额重试 + 长段落切块 ≤1400 字符;
- 译文红线:译文混入
% $ & # ^ _ ~ \ { }会炸 LaTeX(%吞闭括号报 Runaway argument)——sanitize 全角化; - Windows 子进程 PATH 陷阱:注入 env PATH 不生效,xelatex 必须绝对路径调用。
成果:57 篇项目中 35+ 篇完成中英对照版并 git 提交,平均每篇百段级译文、编译 0 错误;详见 log/2026-09-20-work-log.md。
参考来源:skills/lmstudio-hy-mt2-translation/SKILL.md;skills/bilingual-tex-translation/SKILL.md;log/2026-09-20-work-log.md
5 项目开发中如何选择模型与部署集成
模型选择决策矩阵(本组案例的取舍逻辑):
| 子任务 | 需求特征 | 选型 | 理由 |
|---|---|---|---|
| 任务编排/脚本开发 | 强推理、长上下文、工具使用 | Kimi(云端旗舰) | 复杂规划与代码能力优先,token 成本高但占比小 |
| 段落翻译(~5000 段) | 简单英译中、可批量、量大 | hy-mt2-1.8b(本地 1.91GB) | 1.8B 翻译专用模型足够好,本地零 API 成本、内网隐私 |
| PDF 解析 | 版面/公式/表格多模态 | MinerU 2.5-Pro VLM + 小模型流水线 | 专用模型在 OmniDocBench 上远超通用 LLM 直接读 PDF |
原则:让最贵的模型只做最难的决策,让最便宜的算力做最多的重复劳动;专用小模型(翻译/OCR/版面)在垂直任务上性价比全面优于通用大模型。
部署集成两路线对比:
| Docker 部署(MinerU 采用) | HTTP API 接入(LMStudio 采用) | |
|---|---|---|
| 形态 | 容器封装全部依赖,compose 一键起服务 | 宿主程序直接加载模型暴露 REST 端点 |
| 优点 | 环境隔离可复现、多 profile(api/gradio/vllm)、易于迁移到服务器 | 零容器开销、GUI 可现场调参(上下文/offload/并发)、局域网即服务 |
| 缺点 | 镜像大(~150GB 含模型)、调试层级多 | 依赖宿主环境,跨机迁移需重装 |
| 适用 | 团队协作、生产服务化 | 个人工作站、快速试验 |
整合模式:两者并不互斥——本组即"Docker 服务(MinerU)+ 宿主 API(LMStudio)“混布,上层 KimiWork Agent 只通过 HTTP 端点(localhost:7860、192.168.77.1:1234)调用,算力位置对 Agent 透明。扩到云端时,把同样服务部署到租用的 4090/A100 实例即可无缝扩容。
6 不足与展望
不足:
- 翻译质量:1.8B 模型偶发 markdown 残留与术语不一致,无人工审校环节;
- 管线脆性:LMStudio 并发上限低(KV cache 瓶颈),批处理需限速重试;
- 单点部署:MinerU/LMStudio 均在本机,关机即停服,无队列与失败重放;
- 评测缺失:对照版只验证"编译 0 错误”,未量化翻译 BLEU/人工评分。
展望:
- 调度层:引入任务队列(Redis/RQ)与 mineru-router 多卡路由,失败自动重放;
- 模型升级:翻译换 7B 级模型(Qwen 系)或云端 API 兜底,术语表注入保证一致性;
- Skill 生态:把"论文精读"全链路(抓取→解析→翻译→笔记→组会 PPT)封装为一个顶层 Skill + Widget 看板,定时自动产出;
- 算力弹性:高峰翻译任务 offload 到云端竞价实例,本地只留编排与审校。
参考资料汇总
- Wikipedia: History of artificial intelligence
- Vaswani et al. Attention Is All You Need. NeurIPS 2017. https://arxiv.org/abs/1706.03762
- Zhao et al. A Survey of Large Language Models. https://arxiv.org/pdf/2303.18223
- Ho et al. DDPM. 2020;Bubeck et al. Sparks of AGI. 2023
- Huang et al. Understanding the Planning of LLM Agents: A Survey. https://arxiv.org/pdf/2402.02716
- Yao et al. ReAct. ICLR 2023;Shinn et al. Reflexion. NeurIPS 2023
- MinerU 4.x Releases & 模型包. https://github.com/opendatalab/MinerU/releases
- Chen et al. Evaluating LLMs Trained on Code (Codex). https://arxiv.org/abs/2107.03374
- Peng et al. The Impact of AI on Developer Productivity. https://arxiv.org/pdf/2302.06590
- GitHub Blog: Quantifying Copilot’s Impact. 2022-09
- themodernblog: History of AI Coding Tools(NYU Codex 安全性研究转述)
- arXiv:2402.02716 规划综述(反思与修正章节)
- Yao et al. ReAct: https://arxiv.org/abs/2210.03629
- Shinn et al. Reflexion: https://arxiv.org/abs/2303.11366
- arXiv:2601.10338 / 2603.11808:Agent Skills 规范、渐进式披露与安全
- Anthropic: Equipping agents for the real world with Agent Skills. 2025-10;CSDN/51CTO 渐进式披露模式
- 知乎专栏:国内算力租赁平台对比(2025-06);mornai.cn GPU 租赁指南(2026);各平台官网价
- cloudgputracker: NVIDIA H100 vs A100 云端规格与价格对比
- MinerU README. https://github.com/opendatalab/MinerU/blob/master/README_zh-CN.md
- 阿里云开发者社区:MinerU Docker 部署指南(2025-12)
- MinerU 官方 Skill 公告. https://mineru.net/news (2026-03-20)